第六章开始贴近工程实践:用 Transformers + datasets + Trainer + DeepSpeed + peft 这套生态把 LLM 训练流程串起来。
这一章可以整理成一句话:
模型怎么初始化、数据怎么整理进 Trainer、预训练和 SFT 的标签怎么分开、资源不够时怎么换成 LoRA,这四件事就是第六章的主线。
这篇文章按训练流程整理,方便以后回查每一步对应的框架、数据格式和参数。
一、先把第六章的训练流程整理成链路
从工程视角看,第六章讲的是这样一条链路:
| |
这条链路要看的不是框架名字有多熟,而是每个组件承担哪一层职责:
Transformers负责把模型和训练流程抽象成统一接口datasets负责把原始文本或对话数据整理成模型可训练的张量格式Trainer负责承接训练参数、数据集、保存和日志等通用逻辑DeepSpeed负责把训练推到多卡和更大规模上peft负责在资源受限时把全量微调切成 LoRA 这种高效微调路径
复习锚点:Transformers 管模型接口,datasets 管数据流水线,Trainer 管训练脚手架,DeepSpeed 管大规模训练,peft 管高效微调。
图:第六章借助 Hugging Face 生态把模型、数据集与训练框架串到了一起
二、第一步:先把模型和 tokenizer 初始化起来
模型和 tokenizer 初始化负责明确两件事:训练哪个模型,以及文本如何进入这个模型。
第六章选的是 Qwen-2.5-1.5B。Transformers 里有两种常见初始化方式:
- 基于配置从零初始化一个模型
- 基于已有权重加载一个预训练模型
对应到代码里,主干大概就是下面这样:
| |
如果要直接继承已有权重,通常会改成:
| |
2.1 Auto* 这套接口是在接住“模型族差异”
只要配置和权重兼容,AutoConfig、AutoModelForCausalLM、AutoTokenizer 就能把很多模型族差异统一到同一套接口下。这样训练脚本可以把重心放在数据、参数和流程上。
2.2 训练阶段不同,模型加载方式可能不同,但 tokenizer 契约不能乱
无论是 Pretrain 还是 SFT,tokenizer 都是一套输入协议。它定义的是:
- 词表怎么映射
- 特殊 token 怎么表示
- 对话边界怎么标记
- padding 和 EOS 怎么约定
尤其到了后面的 SFT,这个 tokenizer 契约会直接决定 chat template 和 labels 的构造方式。
复习锚点:模型初始化把后续训练步骤接到统一的 Hugging Face 模型接口上;tokenizer 则规定了输入协议。
三、第二步:把预训练数据整理成 Trainer 能直接吃的样子
预训练数据处理负责把原始文本变成 CLM 训练样本。
第六章的预训练流程是 Causal Language Modeling,也就是预测下一个 token。进入 datasets 生态后,数据预处理通常写成流水线:
- 用
load_dataset读入原始 JSON/JSONL - 用 tokenizer 把文本转成 token IDs
- 把多个文本段拼起来,切成固定长度 block
- 令
labels = input_ids.copy()
这段代码骨架最值得回看:
| |
3.1 labels = input_ids.copy() 是预训练阶段的记忆锚点
这句代码明确了:Pretrain 阶段的监督目标就是整段文本自身。
也就是说,预训练数据的重点不在“问题-答案”格式,而在:
- 先把文本稳定 tokenize
- 再拼接成足够长的训练块
- 让每个块都作为一个 CLM 样本参与训练
group_texts 的作用是把多个文本片段拼接后切成固定长度 block。预训练更关注吞吐和有效 token 利用率,而不是保留每段原始文本的天然边界。固定长度 block 可以减少 padding 浪费。
3.2 预训练数据处理是在整理训练协议
进入框架训练后,数据处理要回答四个问题:
- block 多长
- 是否拼接多个样本
labels怎样和input_ids对齐attention_mask由谁生成
这些细节表面上是数据预处理,实际上已经在决定模型训练看到的输入分布。
复习锚点:预训练数据处理就是把“文本 -> token -> block -> labels”这条链放进 datasets.map。
四、第三步:用 Trainer 把训练参数、日志和保存逻辑接起来
Trainer 这一层负责把模型、数据和训练参数装进一个可运行的训练器。
第六章用的是 TrainingArguments + Trainer 这条最典型的 Transformers 路线。骨架很简单:
| |
4.1 TrainingArguments 负责的是“训练策略的通用外壳”
比如:
- batch size
- 梯度累积
- 学习率
- 日志频率
- 保存策略
- gradient checkpointing
这些参数放进 TrainingArguments 后,模型逻辑、数据逻辑和训练策略开始分层。
4.2 Trainer 统一的是训练脚手架
到了这里,很多通用工作都不需要自己再反复写:
- 前向和反向训练循环
- 日志打印
- checkpoint 保存
- tokenizer/data collator 接入
- 分布式训练接口对接
复习锚点:Trainer 的价值不是替代理解,而是把已经理解的训练骨架抽成可复用模板。
五、第四步:从 notebook 走向可长期运行的 DeepSpeed 训练脚本
前几节解决“如何用框架表达训练流程”,DeepSpeed 解决“如何把训练推进到多卡和更大模型规模”。
第六章进一步给出了:
pretrain.pyfinetune.pypretrain.shfinetune.shds_config_zero2.json
这说明训练流程已经从“演示思路”切换到了“脚本化运行”。
pretrain.sh 的典型启动方式大致是这样:
| |
5.1 DeepSpeed 在这一章里主要承担两件事
第一,让训练自然走向多卡。第二,通过 ZeRO 等策略降低显存压力。
ds_config_zero2.json 里最该看的关键词是 zero_optimization.stage = 2。这表示采用 ZeRO-2,主要优化优化器状态和梯度的存储开销。
5.2 从 notebook 到脚本,增加的是工程外壳
比如在 pretrain.py 里,第六章补上了很多真实训练需要的东西:
HfArgumentParser解析命令行参数- checkpoint 恢复
- 主进程数据预处理
- SwanLab 日志
- shell 层统一管理训练超参
这时可以区分两类内容:
- notebook 负责验证思路
- 脚本负责承接长时间训练
复习锚点:DeepSpeed 和 shell 脚本把训练从教学演示推进到可长期运行、可恢复、可记录的工程流程。
六、第五步:进入 SFT 后,差异主要在数据构造
Pretrain 和 SFT 可以共享同样的 Trainer、DeepSpeed 和大部分训练框架,但它们的数据构造逻辑并不一样。
原因是训练目标不同:Pretrain 学整个文本分布,SFT 学“给定指令后 assistant 应该怎样回答”。
所以进入 SFT 之后,要先问:
- 对话怎么拼
- 角色怎么标
- 哪些 token 参与 loss
- padding 和 mask 怎么处理
第六章这里沿用了 Qwen 风格的 chat template,骨架大致像这样:
| |
6.1 这一节要盯住 labels 的构造方式
对 SFT 来说,不是所有 token 都应该参与 loss。
设计上要分清:
system部分不参与拟合user部分不参与拟合assistant回复部分才是主要监督目标
这也是为什么 SFT 数据集看起来和 Pretrain 都是 input_ids + labels + attention_mask,但实际语义完全不同。
如果用一句更压缩的话来说:
Pretrain 的
labels是整段文本的镜像,SFT 的labels只对回答区域打开监督信号。
6.2 chat template 是训练协议的一部分
在 SFT 中,<|im_start|>、<|im_end|>、角色标识、换行符这些 token 不是普通格式装饰,而是在定义:
- 对话轮次边界
- 角色身份
- system/user/assistant 的结构关系
所以,SFT 数据处理其实是在定义对话训练协议。
6.3 attention_mask 和 padding 依然不能忽视
到这里之后,padding 会影响:
- 哪些位置被模型看到
- 哪些位置不参与 loss
- batch 内不同长度样本如何对齐
很多实现里 IGNORE_TOKEN_ID 会取 -100,因为这是 PyTorch 交叉熵里常见的忽略标签值。第六章的脚本更偏教学示意,复习时重点记“标签遮蔽”这个动作。
复习锚点:SFT 和 Pretrain 最大的不同,不在 Trainer,而在“谁参与监督”。
七、第六步:资源不够时,就把全量微调切到 LoRA
第六章最后补上高效微调。它先介绍 Adapter、Prefix Tuning 等思路,再把重心落到 LoRA:用较少可训练参数完成任务适配。
LoRA 的形式可以写成:
$$ W = W_0 + BA $$其中 $W_0$ 是冻结的原始权重,$A$ 和 $B$ 是低秩增量矩阵。训练时原始权重保持冻结,主要更新这两个低秩矩阵。
工程落点主要是 peft 的用法:
| |
7.1 LoRA 在这一章里负责的是“把可训练参数缩到更小”
它最适合的场景,是:
- 模型参数很大
- 训练资源有限
- 任务更偏行为适配或领域适配
在训练链路上,LoRA 给 SFT 这类后训练阶段提供了更轻量的参数更新方式。
7.2 peft 抽象了 LoRA 注入过程
对工程实践来说,我会记这几件事:
- 目标层往往是
q_proj、v_proj这类注意力投影层 LoraConfig用来描述 LoRA 超参get_peft_model会把 LoRA 注入到原模型里
实战里要决定:
- 微调目标是什么
- LoRA 应该插到哪些层
- rank、dropout、alpha 怎么取
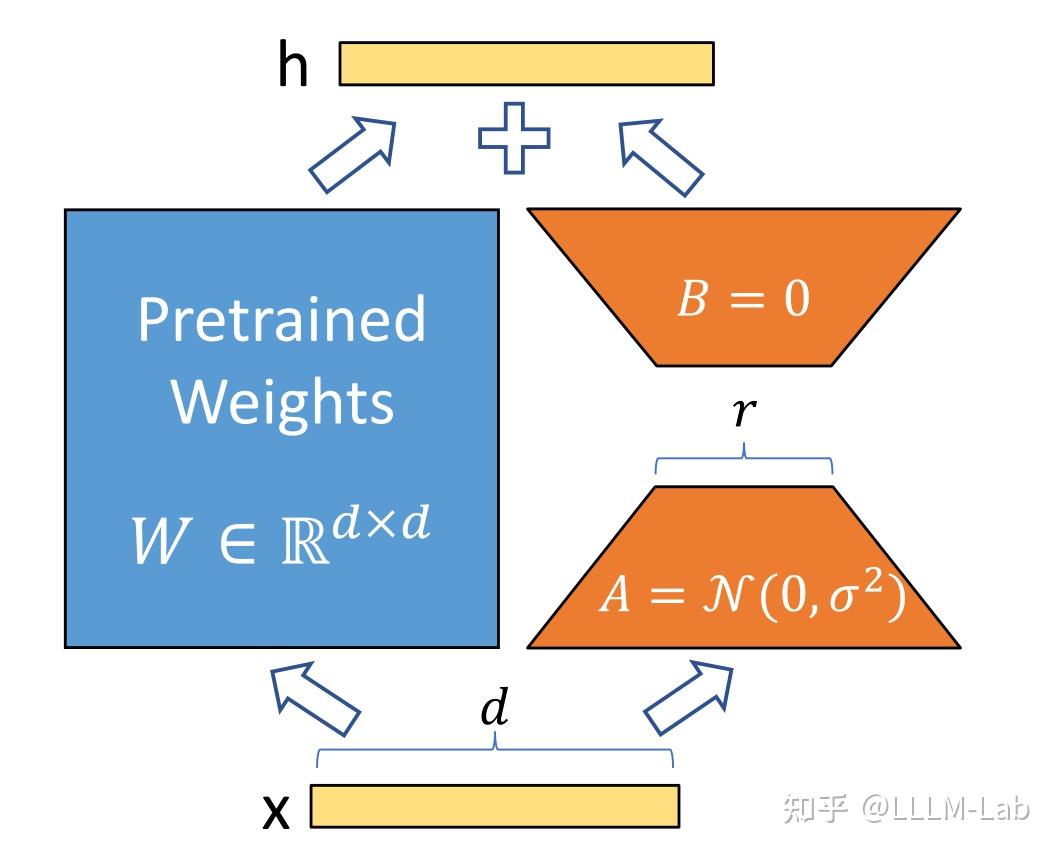
图:LoRA 用低秩增量更新替代全量参数更新
7.3 LoRA 的边界
LoRA 适合任务适配和低成本后训练;如果目标是让模型吸收大量新知识,它往往不是最理想路径。
所以从训练链路上看,我更愿意这样理解:
- Pretrain 更偏知识底座
- SFT 更偏助手行为塑形
- LoRA 更偏低成本适配
复习锚点:LoRA 是把后训练成本压下来的高效微调路线,不是替代预训练的知识注入方案。
八、写在最后:第六章搭起的训练骨架
整章可以总结成下面这条主线:
- 用
AutoConfig / AutoModel / AutoTokenizer接入模型和 tokenizer - 用
datasets.map和group_texts把预训练数据整理成 CLM block - 用
TrainingArguments + Trainer承接训练骨架 - 用
DeepSpeed + ZeRO-2把训练推向更真实的多卡脚本环境 - 在 SFT 阶段把重心切到
chat template + labels + attention_mask - 在资源受限时用
LoRA + peft替代全量微调
第六章搭起来的是一套基于主流框架的训练流程骨架:
Pretrain -> SFT -> LoRA
这条链路里,每一层的职责也更清楚了:
- 模型层负责承接结构和权重
- 数据层负责定义训练协议
- Trainer/DeepSpeed 负责承接训练基础设施
- LoRA 负责在后训练阶段压缩更新成本
6.4 的偏好对齐部分可以看成全景补充:训练链路后面还会走向奖励模型、RLHF、DPO 等阶段。但第六章落到可复用实践上的重点,仍是前面这条框架化训练主线。
复习结论:第六章把大模型训练放进了主流工程栈里,而不是只停在模型结构图上。