第七章的主题很集中:大模型进入应用场景后,先要评估能力边界,再接入外部知识,最后才谈工具调用和任务执行。
这一章可以按三个模块复习:评测、RAG 和 Agent。评测判断模型在哪些任务上可靠;RAG 把外部文档接入生成过程;Agent 让模型通过工具参与行动。
整章可以整理成下面这条应用链路:
| |
这一章可以先按三层记:能力边界、知识接入、工具行动。
一、先从评测开始:不要只问模型强不强
进入应用层后,最容易犯的错误是把模型能力说得太笼统:一个模型在榜单上分数高,不代表它能胜任所有场景。
做应用时,要把“强不强”拆成具体能力问题:
- 它是否懂通用知识
- 它数学推理是否稳定
- 它能不能处理长文本
- 它多语言能力怎样
- 它是否会正确使用工具
- 它在金融、法律、医疗等垂直领域是否可靠
所以第七章把评测集按能力拆开看,比如 MMLU 偏通用多任务理解,GSM8K/MATH 偏数学推理,ARC/GPQA/HellaSwag 偏推理和常识,InfiniteBench/Multi-needle 偏长文本,MGSM 偏多语言数学。
评测是在给应用选择画边界。
比如我要做知识问答系统,就不能只看聊天榜单,还要看事实性、长文档理解和检索后回答是否忠实。我要做工具型助手,就不能只看语言流畅度,还要关心工具调用正确率、参数是否填对、失败时能不能恢复。
复习锚点:评测不是为了得到一个总分,而是为了判断模型适合放进哪个场景,以及哪些能力不能靠感觉判断。
二、RAG:把模型从“只靠参数记忆”拉回到外部知识
第七章第二部分进入 RAG。这里的背景很直接:LLM 虽然会生成,但它有几个天然问题:
- 训练数据可能过时
- 专业领域知识不一定充分
- 输出可能产生幻觉
- 很难直接给出可追溯依据
RAG 的思路很直接:生成之前先检索。用户提出问题后,系统先从文档库里找相关片段,再把这些片段作为上下文交给模型,让模型基于外部材料回答。
RAG 的主链路可以写成:
| |
RAG 把知识系统拆成两个部分:
- 模型负责理解问题、组织语言和生成答案
- 检索系统负责把当前问题最需要的外部证据找出来
两者配合以后,应用可以把最新资料、私有文档、领域手册接到生成链路里,减轻对模型参数记忆的依赖。
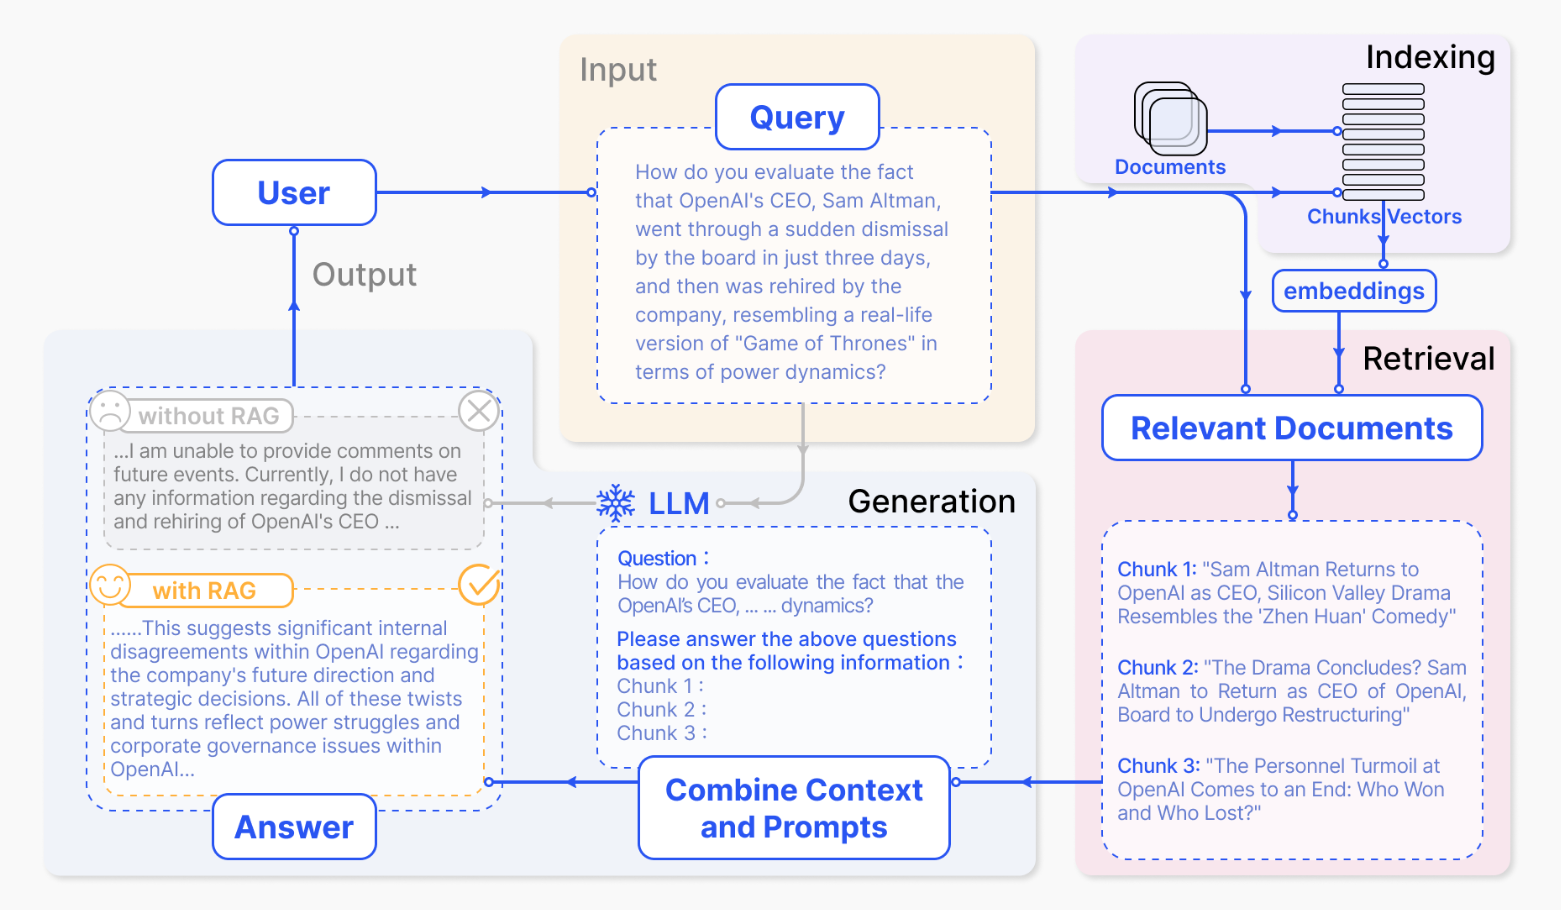
图:RAG 先检索相关上下文,再让模型基于上下文生成回答
三、Tiny-RAG:最小实现里要盯住的几个模块
第七章还写了一个 Tiny-RAG。这个实现很适合学习,因为它把 RAG 系统拆成了几个足够小的部件:
- 文档加载与切分:
ReadFiles - 向量化:
BaseEmbeddings/OpenAIEmbedding - 向量存储与检索:
VectorStore - 生成模型封装:
OpenAIChat - 演示入口:
demo.py
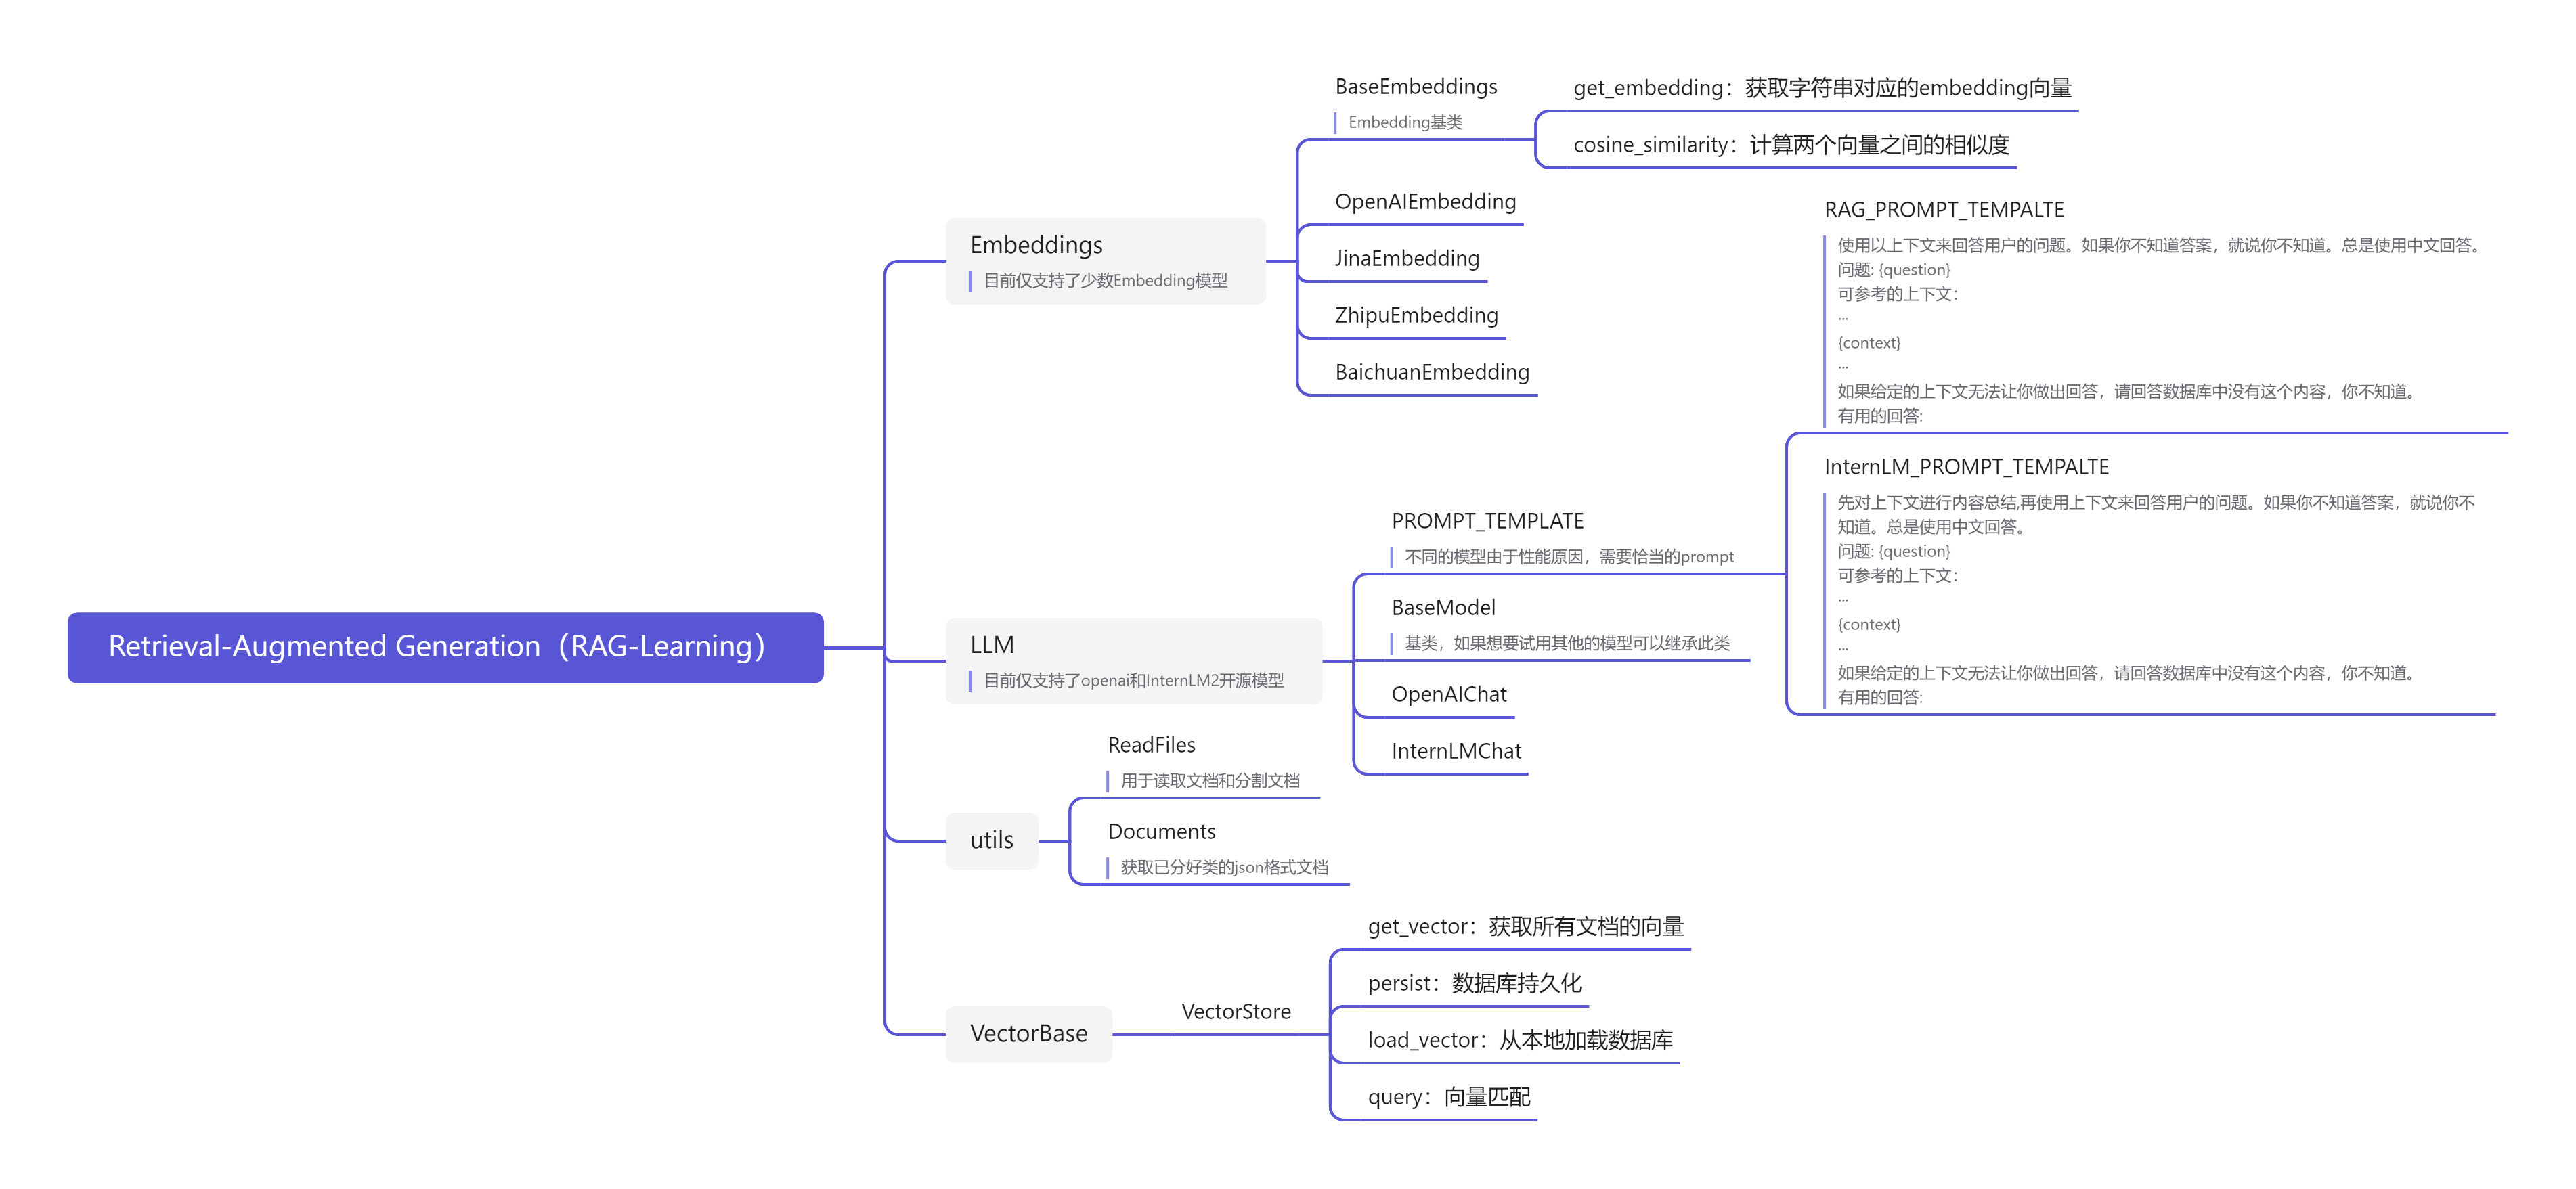
图:Tiny-RAG 把 RAG 拆成文档、向量、检索和模型回答几个最小模块
3.1 文档切分决定证据粒度
文档加载部分支持 pdf/md/txt,读出来之后会按 token 长度切成 chunk。这里要记两个参数:
| |
max_token_len 控制每个片段不要太长,cover_content 则给相邻片段保留重叠内容。这个重叠很重要,因为很多语义边界不会刚好落在切分点上。如果完全硬切,检索时很容易丢掉上下文。
所以 chunk 策略本质上是在做取舍:
- chunk 太短,语义不完整
- chunk 太长,检索不精确,而且占上下文
- 重叠太少,边界信息容易断
- 重叠太多,索引膨胀,成本增加
复习锚点:chunk 策略表面上是数据预处理,实际是在决定模型后面能看到什么证据。
3.2 向量化层要抽象出来
第七章先定义 BaseEmbeddings,再写 OpenAIEmbedding。这个设计很朴素,但教学价值很清楚:embedding 模型应该作为可替换模块接入 RAG。
| |
这里的重点在于接口抽象:embedding 模型被包装成了可替换模块。以后如果从 API embedding 换成本地 embedding,RAG 主流程不用大改,只要新的类实现 get_embedding 就行。
复习锚点:RAG 里的模型不止最终生成回答的 LLM,还有负责把文本映射到向量空间的 embedding 模型。embedding 质量不好,LLM 再强也可能拿不到正确上下文。
3.3 向量库的最小检索逻辑就是相似度排序
Tiny-RAG 的 VectorStore 很轻量:把文档片段和向量保存下来,查询时计算问题向量和每个文档向量的相似度,然后取 Top-k。
| |
这个版本属于教学级向量数据库,它把最基本的动作讲明白了:
- 问题也要向量化
- 问题向量和文档向量进入同一个空间比较
- 相似度最高的片段被取出来作为上下文
后续做项目时,可以把这里替换成 FAISS、Milvus、Qdrant、Chroma 之类的向量库,也可以补 reranker。但无论外壳怎么换,目标都还是“找到和问题最相关的上下文”。
3.4 RAG prompt 要约束模型只基于上下文回答
最后,OpenAIChat 会把检索到的内容放进一个 RAG 专用 prompt。这个 prompt 要明确告诉模型:
- 使用给定上下文回答
- 不知道就说不知道
- 上下文不足时不要编
- 用中文回答
这个 prompt 给模型增加“证据约束”:答案应建立在可追溯材料上。RAG 做得好不好,要回到评测中看事实一致性、引用准确性和答案忠实性。
四、RAG 的学习收获:系统质量不只取决于 LLM
RAG 系统的质量,很大一部分取决于生成模型之外的环节。
如果答案错了,可能原因很多:
- 原始文档质量不好
- 切分粒度不合适
- embedding 模型不匹配
- Top-k 召回错了
- prompt 没有限制模型
- 模型没有正确使用上下文
这和直接问 LLM 很不一样。直接问模型时,问题通常被归因到“模型会不会”。但到了 RAG,系统多了检索层、索引层、上下文构造层,错误也会分散到更多地方。
所以看 RAG 系统时,不要只问“接了什么大模型”,还要问:
- 文档怎么切
- 向量怎么建
- 检索怎么排
- 上下文怎么塞
- 回答怎么评
这几个问题答清楚,才算开始理解 RAG 的系统质量。
五、Agent:从“会回答”走向“会调用工具”
第七章最后讲 Agent。它先给了一个比较完整的定义:LLM Agent 以 LLM 为中心,结合目标理解、规划、记忆、工具使用、反思迭代等能力,去完成更复杂的任务。
Agent 可以整理成一句话:
Agent 是把 LLM 放进一个可行动的任务系统里。
普通聊天模型的输出主要是文字。Agent 的变化在于,模型可以在合适的时候选择工具,比如查时间、搜索百科、查询天气、做计算,然后把工具结果继续放回对话,让模型生成最终回答。
Agent 改变了 LLM 的角色:模型不只是生成文本,还参与调度工具。它需要承担这些职责:
- 判断用户到底要什么
- 判断是否需要外部工具
- 选择正确工具
- 填好工具参数
- 读取工具返回结果
- 继续生成自然语言回复
第七章也把 Agent 粗略分成任务导向型、规划推理型、多 Agent 系统、探索学习型几类。当前复习可以先抓任务导向型,因为 Tiny-Agent 主要演示的就是这条最小链路。
六、Tiny-Agent:tool calling 的最小闭环
Tiny-Agent 的实现围绕 OpenAI 兼容接口里的 tool_calls 展开。它有三个部件:
- 工具函数
- 工具 schema 转换
- Agent 对话与工具调用循环
工具函数本身很普通,比如获取时间、搜索 Wikipedia、查询天气。但在 Agent 里,普通函数要变成模型可理解的工具,就必须有清晰的函数名、参数类型和 docstring。
| |
接着,function_to_json 会读取函数签名,把它转换成 tool schema:
| |
模型看到的是结构化 schema。工具描述不清楚、参数设计不合理,模型就更容易选错工具或填错参数。
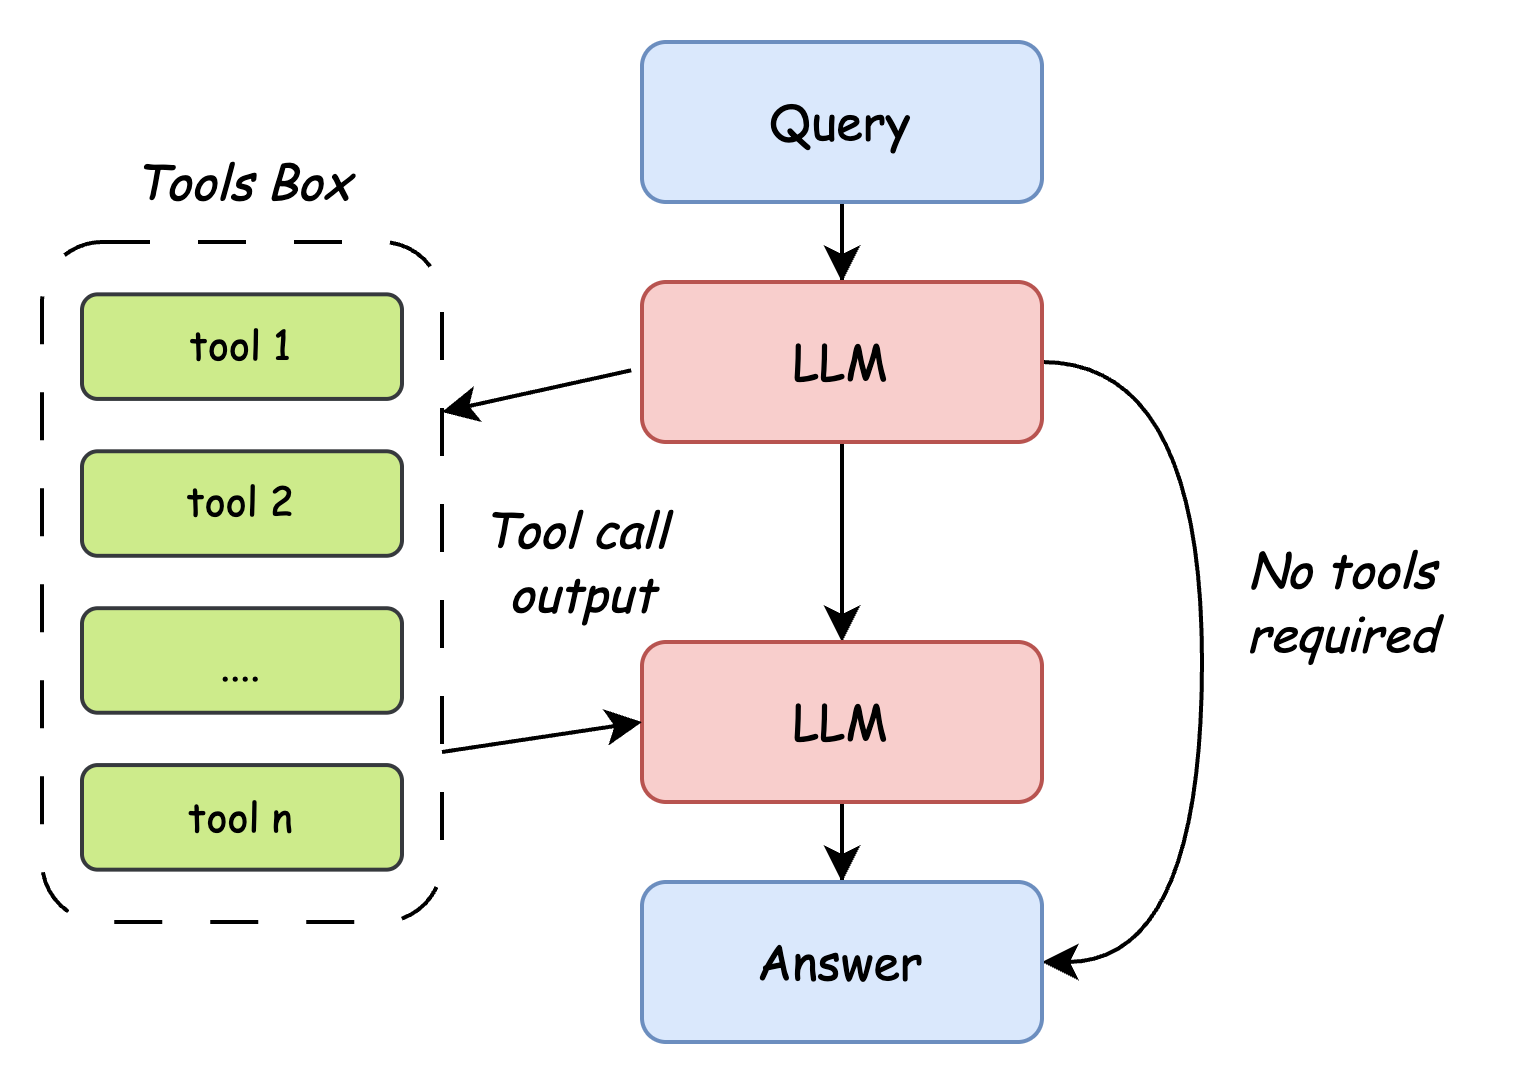
图:Tiny-Agent 的流程是模型提出工具调用,程序执行工具,再把结果交回模型
6.1 Agent 类负责维护调用循环
Agent.get_completion 的流程可以简化成这样:
| |
这个循环说明了 tool calling 的边界:模型输出结构化调用请求,外层程序执行工具,工具结果再回到模型上下文中。
所以 Agent 的可靠性同时取决于模型和外层控制逻辑:
- 工具是否有白名单
- 参数是否校验
- 调用失败怎么恢复
- 工具返回是否可信
- 历史消息是否会越积越乱
这些问题在纯聊天模型里不太显眼,但一旦模型开始调用工具,就必须认真处理。
6.2 Tiny-Agent 很适合作为 Agent 入门
第七章前面介绍了规划、记忆、反思等能力,但配套 Tiny-Agent 主要还是一个 tool calling demo。它有工具、有消息历史、有二次模型调用,但还没有实现复杂规划、长期记忆或反思循环。
作为学习入口,它很合适,因为它先把基础接口关系讲清楚了:
- 工具如何暴露给模型
- 模型如何提出工具调用
- 程序如何执行工具
- 工具结果如何回到模型上下文
等这一层明白之后,再看 ReAct、多 Agent、长期记忆、任务规划,才不会只停在概念名词上。
工程边界也要记住:Tiny-Agent 中用 eval(...) 执行工具调用,适合教学演示;真实系统应该换成更安全的白名单分发。模型一旦能触发工具,权限和安全边界就必须认真处理。
七、这一章留给我的应用层框架
这一章最适合留下一个应用层框架:
| |
这里有三个复习结论:
评测要看具体任务边界
榜单分数只能提供参考,应用还要关心场景、数据、语言、工具和安全边界。RAG 要把知识放到可更新的位置
外部文档、向量索引和检索结果共同决定模型能看到哪些依据。Agent 要把工具调用纳入控制流程
Agent 让模型不仅能回答,还能通过工具查询、计算、搜索和执行任务。
第七章适合作为应用入口。Tiny-RAG 和 Tiny-Agent 给出了最小可运行骨架,帮助先看清系统边界。
八、写在最后:应用层要把不可靠变得可控
大模型应用不能只盯着模型本身,还要补上评测、检索、工具、日志和控制边界。
评测告诉我模型哪里能用,RAG 让回答尽量有依据,Agent 让模型可以接入行动接口。目标很实际:让模型在真实场景里更可控。
如果只保留这一章的学习结论,可以记住三句话:
- 评测负责应用边界。
- RAG 负责外部知识接口。
- Agent 负责工具调度。
复习应用层时,关注点要落到三件事:系统怎样设计、怎样观测、怎样迭代。